Estos son algunos ejercicios que pueden realizarse para practicar lo aprendido en el tema de Aprendizaje Supervisado, sobre el uso de las biblioteca Scikit-Learn desde Python, principalmente.
⚠️Salvo que se indique lo contrario, estos ejercicios pueden resolverse en condiciones de prueba final, esto es, examen individual en el laboratorio, sin acceso a Internet y sin usar IA generativa. Tan sólo hace falta la plantilla o el contexto que proporcione el profesor junto al enunciado, y un servidor de lenguaje como Pylance que viene por defecto en la extensión oficial de Python para Visual Studio Code y que permite explorar la documentación del API.
- En una desarrolladora de videojuegos móviles quieren predecir si un jugador abandonará el juego (churn) según los días que lleva sin conectarse y las microtransacciones realizadas. Se entrena un modelo de
LogisticRegressiony se ejecuta el siguiente código. ¿Qué diferencia existe en la salida producida por model.predict() frente a model.predict_proba() y por qué la función logística/sigmoide es la que permite esta interpretación probabilística? Explica qué efecto tendría cambiar el umbral de decisión predeterminado (por defecto 0.5) a 0.3 para la clase 1 (churn). ¿Qué implicación práctica tendría en la retención de usuarios?
import numpy as np
from sklearn.linear_model import LogisticRegression

# X: [dias_inactivo, total_compras_euros]
X_train = np.array([
    [1, 50.0], [2, 0.0], [14, 0.0], [20, 10.0],
    [30, 0.0], [3, 100.0], [25, 5.0], [18, 0.0]
])
# y: 1 si abandona el juego (churn), 0 si permanece activo
y_train = np.array([0, 0, 1, 1, 1, 0, 1, 1])

# Modelar y entrenar

# Evaluación de dos jugadores nuevos
X_nuevos = np.array([[2, 10.0], [15, 0.0]])
# Predecir

print("Predicciones de clase:", predicciones)
print("Matriz de probabilidades:\n", probs)- Analizando la retención de un juego según la duración del contenido principal, un analista de datos entrena tres modelos de regresión polinómica (grados 1, 2 y 9) utilizando una división del conjunto de datos en entrenamiento y validación cruzada. La tabla muestra el error residual (coste J) en ambos conjuntos.
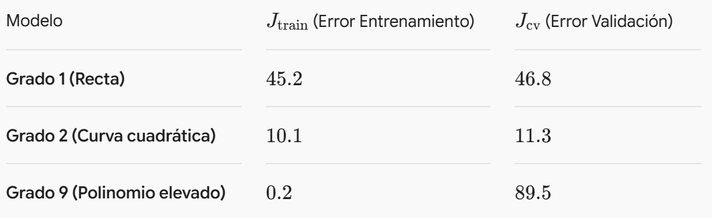
Diagnostica la situación teórica (Sesgo/Varianza, Subajuste/Sobreajuste) para el modelo de Grado 1 y el de Grado 9 basándote en la relación entre sus costes de entrenamiento y validación. Si estuviéramos obligados a trabajar con el modelo de Grado 9 por razones del sistema, ¿qué técnica de regularización (L1 ó L2) podrías aplicar sobre la función de coste y qué efecto matemático tiene sobre los pesos w?
- Un modelo supervisado de detección de tramposos (cheaters) en partidas clasificatorias en línea ha generado el siguiente reporte tras evaluar 1500 jugadores (como comentario en el código). Calcula la Sensibilidad y la Precisión para la clase objetivo (tramposos / clase 1). En el diseño de un sistema de suspensión automática de cuentas de usuario, ¿cuál de los dos tipos de error (Falsos Positivos o Falsos Negativos) es más crítico reducir y qué métrica nos indicaría que el sistema es muy seguro ante baneos injustificados?
from sklearn.metrics import classification_report, confusion_matrix

# Matriz de confusión obtenida:
# [[1100,  20],   Row 0: Jugadores Legítimos (Clase 0)
# [ 80, 300]] Row 1: Tramposos / Cheaters (Clase 1)- Observa el código de entrenamiento de un clasificador para distinguir el tipo de comportamiento de bots mediante Support Vector Machines. Sabiendo que los datos sintéticos
make_moonsrepresentan dos semicírculos entrelazados que no son linealmente separables, ¿por qué el núcleokernel='linear'resultará insuficiente y qué función de núcleo (ej.'rbf') deberíamos emplear para aplicar el «truco del kernel» (kernel trick)? Modifica la instanciación del objetoSVCutilizandokernel='rbf'y ajustando el parámetro de regularización C=10.0. Explica qué sucede visualmente con la frontera de decisión si incrementamos demasiado el valor del hiperparámetro C.
from sklearn.svm import SVC
# Generador de datos sintéticos
from sklearn.datasets import make_moons

# Generación de datos sintéticos con make_moons
X, y = make_moons(n_samples=200, noise=0.3, random_state=42)

# Creación y entrenamiento del modelo- Para clasificar las clases de personajes de un videojuego (Guerrero, Mago, Pícaro) en función de la Salud Máxima y el Poder Mágico, se requiere utilizar el algoritmo de K Vecinos más Cercanos. Como se basa en la distancia euclídea entre muestras, es imprescindible realizar primero un escalado de datos. Primero completa la inicialización del objeto StandardScaler y transforma las características de entrada X_train y X_test. Después instancia el modelo KNeighborsClassifier configurandolo para 3 vecinos. Entrena el modelo y calcula la precisión de exactitud en el conjunto de prueba.
import numpy as np
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split

np.random.seed(42)
# X: [salud, mana]
X = np.random.uniform(100, 1000, (150, 2))
# y: 0=Guerrero, 1=Mago, 2=Pícaro
y = np.random.choice([0, 1, 2], size=150)

# Particiones

# 1. Escalar características
# scaler = ...
# X_train_scaled = ...
# X_test_scaled = ...

# 2. Crear y entrenar K-NN
# knn = ...
# knn.fit(...)

# 3. Evaluar exactitud y mostrarla
# acc = knn.score(...) - Se pretende predecir si un usuario comprará un pase de batalla (Pase Adquirido: 0 o 1) utilizando la información de su Nivel de Cuenta, Horas Jugadas y Victorias Totales. Para evitar que el árbol memorice las muestras de entrenamiento (sobreajuste por profundidad excesiva), es necesario limitar su desarrollo mediante hiperparámetros. Primero instancia y entrena un
DecisionTreeClassifierconfigurando la profundidad máximamax_depth=3. Después exporta las reglas aprendidas por el árbol en texto legible utilizando la funciónexport_textde Scikit-Learn.
import pandas as pd
from sklearn.tree import DecisionTreeClassifier, export_text
from sklearn.model_selection import train_test_split

# Datos de muestra de jugadores
data = {
    'nivel': [5, 12, 45, 80, 23, 67, 10, 95, 34, 50],
    'horas': [10, 25, 120, 200, 40, 150, 15, 300, 60, 100],
    'victorias': [2, 5, 40, 90, 12, 70, 3, 110, 18, 45],
    'compro_pase': [0, 0, 1, 1, 0, 1, 0, 1, 0, 1]
}
df = pd.DataFrame(data)
X = df[['nivel', 'horas', 'victorias']]
y = df['compro_pase']

# 1. Crear el árbol de decisión limitado a profundidad 3
# tree = ...
# tree.fit(X, y)

# 2. Imprimir las reglas del árbol entrenado usando export_text
# reglas = export_text(...)- Para optimizar un modelo de
RandomForestClassifierencargado de predecir la victoria o derrota de un equipo en una partida MOBA, se debe probar sistemáticamente distintas combinaciones del número de estimadores y la profundidad máxima de los árboles. Primero define el diccionario de parámetrosparam_gridpara probar enn_estimatorslos valores $[10, 50]$ y enmax_depthlos valores [3, 5, \text{None}]. Luego configura e iniciaGridSearchCVempleando validación cruzada con 3 pliegues (cv=3). Finalmente muestra por pantalla la mejor combinación de hiperparámetros encontrada (best_params_).
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV

np.random.seed(42)
# X: Muestras simuladas de partidas [oro_diferencia, bajas_diferencia, torres_destruidas]
X_train = np.random.randn(100, 3)
y_train = np.random.choice([0, 1], size=100)

# 1. Definir la rejilla de parámetros
# param_grid = { ... }

# 2. Crear el objeto GridSearchCV con RandomForestClassifier y cv=3, y entrenarlo
# grid_search = GridSearchCV(...)

# 3. Mostrar los mejores parámetros
# best_params_- Se desea predecir la puntuación final (Score) que obtendrá un jugador en un nivel de plataformas continuo a partir de tres métricas de rendimiento: Monedas Recogidas, Tiempo Empleado (s) y Enemigos Derrotados. Debido a que las redes neuronales son hiper-sensibles a la escala de las entradas, usaremos un flujo estructurado con
StandardScaler. Primero instancia unMLPRegressorconfigurando una capa oculta con 16 neuronas (hidden_layer_sizes=(16,)), función de activación'relu', el optimizador'lbfgs'(adecuado para conjuntos de datos pequeños) e iteraciones máximasmax_iter=500. Después normaliza los datos de entrenamientoX_trainusandoStandardScaler. Finalmente entrena la red neuronal y realiza la predicción para el conjunto de testX_test.
import numpy as np
from sklearn.neural_network import MLPRegressor
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split

np.random.seed(42)
X = np.random.uniform(1, 100, (200, 3)) # Métrica de jugador
y = X[:, 0] * 10 + X[:, 1] * (-2) + X[:, 2] * 50 # Puntuación sintética

X_train, X_test, y_train, y_test = ...

# 1. Escalar características

# 2. Definir e instanciar el perceptrón multicapa MLPRegressor (usando solver='lbfgs')
# mlp = MLPRegressor(hidden_layer_sizes=(16,), activation='relu', solver='lbfgs', max_iter=500, random_state=42)

# 3. Ajustar el modelo y realizar predicciones
# mlp.fit(X_train_scaled, y_train)
# predicciones - Para asegurar un flujo de trabajo profesional y evitar la fuga de datos (data leakage) entre entrenamiento y prueba, se deben encadenar las etapas de transformación y clasificación en un objeto
Pipelinede Scikit-Learn. Se utilizaráMinMaxScalerjunto a un clasificadorLogisticRegressionpara categorizar el tipo de jugador (VIP / Estándar). Primero crea unPipeline(o usamake_pipeline) que integre en el primer paso la escalaMinMaxScalery en el segundo el clasificadorLogisticRegression. Después entrena el pipeline directamente sobre los datos sin escalarX_trainyy_train. Finalmente evalúa la precisión global empleando el método.score(X_test, y_test).
import numpy as np
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import MinMaxScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

np.random.seed(42)
X = np.random.uniform(0, 5000, (100, 2)) # X: [gemas_compradas, minutos_juego]
y = (X[:, 0] > 2000).astype(int)          # y: 1 si es jugador VIP, 0 en otro caso

X_train, X_test, y_train, y_test = ...

# 1. Crear el pipeline combinando MinMaxScaler y LogisticRegression
# pipeline = make_pipeline(...)

# 2. Entrenar el pipeline completo
# pipeline.fit(X_train, y_train)

# 3. Evaluar en test, con la precisión - Con el objetivo de evaluar la robustez de un clasificador de hábitos de juego multiclase (Casual, Core, Hardcore) de forma imparcial, es preferible utilizar validación cruzada K-Fold en lugar de una partición fija tipo Hold-Out. Primero instancia un modelo NaiveBayes gaussiano (GaussianNB). Después aplica la función cross_val_score con 5 pliegues (cv=5), configurando la métrica de puntuación en scoring=’f1_macro’. Finalmente calcula e imprime el valor medio y la desviación estándar de las puntuaciones obtenidas en los pliegues.
import numpy as np
from sklearn.naive_bayes import GaussianNB
from sklearn.model_selection import cross_val_score

np.random.seed(42)
X = np.random.randn(120, 4) # 4 características de comportamiento
y = np.random.choice([0, 1, 2], size=120) # 3 clases de perfil de jugador

# 1. Instanciar el clasificador GaussianNB
# model = ...

# 2. Calcular los scores usando cross_val_score con cv=5 y scoring='f1_macro'

# 3. Mostrar la media y desviación estándar de los resultados
# print(f"F1-Macro Promedio: {scores.mean():.3f} +/- {scores.std():.3f}")
Esta página está licenciada bajo CC BY-NC-SA 4.0 por Laboratorios Narratech.