La Estadística es la ciencia formal (originalmente una rama de las Matemáticas) que se encarga de recolectar, organizar, resumir, analizar e interpretar datos para convertir información numérica en conocimiento y tomar decisiones racionales bajo condiciones de incertidumbre.
Su importancia en Ciencia de Datos es indiscutible. La estadística es el cimiento teórico sobre el que se construye dicha Ciencia y sin ella, los algoritmos de Aprendizaje Automático serían cajas negras incomprensibles. La Estadística proporciona el lenguaje para entender la distribución de las variables, medir la incertidumbre, validar si un patrón descubierto es real o fruto del azar (ej. mediante contrastes de hipótesis) y garantizar que los modelos que construimos generalicen correctamente ante datos nuevos en lugar de limitarse a «alucinar» o memorizar el pasado.
Análisis exploratorio de datos
Como parte de la Minería de Datos es interesante no sólo visualizar y aplicar nuestra intuición sobre los datos que tenemos, sino saber analizarlos con rigor estadístico (estructura de los datos, relaciones entre sus variables, etc.).
Análisis univariante
Antes de analizar interacciones, es imprescindible caracterizar cada variable de forma aislada y evaluar si se cumplen los supuestos que luego permitirán usar (o no) los distintos métodos paramétricos.
Medidas de tendencia central y dispersión
- Media (mu) y Desviación Típica (sigma): Sensibles a valores atípicos. Adecuadas para distribuciones simétricas y sin colas pesadas.
- Mediana y Rango Intercuartílico (IQR = Q3 – Q1): Estadísticos robustos basados en rangos. Indicados cuando existen distribuciones sesgadas o presencia de valores atípicos.
Evaluación de la Normalidad
Muchos algoritmos y pruebas estadísticas asumen que las variables continuas siguen una distribución normal N(mu, sigma). La normalidad se evalúa mediante:
- Asimetría (Skewness) y Curtosis: Un valor de asimetría cercano a 0 indica simetría; la curtosis mide el peso de las colas (el «aplastamiento» de la distribución).
- Pruebas de hipótesis formales:
- Shapiro-Wilk: Indicada para muestras pequeñas (n menor que 50).
- Kolmogorov-Smirnov (con corrección de Lilliefors): Indicada para muestras de mayor tamaño (n mayor o igual que 50).
Regla de decisión: Si el p-valor < alpha (habitualmente y por motivos históricos se suele establecer un alpha de 0,05), se rechaza la hipótesis nula de normalidad, lo que obliga a emplear métodos no paramétricos o aplicar transformaciones de estabilización de varianza (como la transformación logarítmica log(x) o Box-Cox.
Análisis bivariante
La elección del estadístico para medir la asociación entre dos variables X e Y depende estrictamente del tipo de datos (cuantitativos o cualitativos) y del cumplimiento de supuestos paramétricos.
Para estudiar relaciones y correlaciones entre variables hay que empezar por preguntarse de que tipo son estas. Si son variables cuantitativas, y además se dan los supuestos de normalidad y linealidad, se usa el coeficiente de Pearson; si no se dan los supuestos, coeficiente de Spearman / Kendall. Si son variables cualitativas, se usa una tabla de contingencia y el test de Chi al cuadrado más la V de Cramer.
Dos variables cuantitativas continuas
Miden la dirección y la intensidad de la asociación entre dos métricas numéricas.
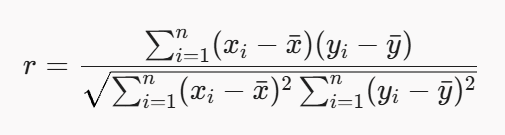
- Coeficiente de Correlación de Pearson (r):
- Condiciones: Ambas variables deben ser cuantitativas continuas, presentar una relación lineal y seguir una distribución normal bivariante (ausencia de valores atípicos severos).
- Fórmula: La que aparece arriba.
- Rango: [-1, 1]. Mide únicamente la fuerza de la dependencia lineal entre esas dos variables continuas. El ejemplo simplista pero típico es: «cuanto más metros cuadrados tiene una casa, más cara es», o nosotros diríamos «cuantas más horas de duración tiene un videojuego, más caro es».
- Coeficiente de Correlación por Rangos de Spearman (rho, parecido a una p):
- Condiciones: Método no paramétrico. No asume normalidad ni linealidad estricta. Adecuado cuando los datos son ordinales o existe una relación monotónica (creciente o decreciente, aunque no sea una recta). Como las métricas de éxito en videojuegos (ej. el volumen de reseñas que tiene un título) suelen tener distribuciones no normales (en absoluto se asemejan a una campana de Gauss) con colas muy largas (long tail, debido a la llamada Ley de Potencias –Power Law– o Distribución de Pareto -el 80% de los efectos proviene solamente del 20% de las causas-), el coeficiente de correlación por rangos de Spearman es más robusto que el de Pearson.
- Mecanismo: Reemplaza los valores reales por sus rangos o posiciones ordenadas antes de calcular la correlación.
- Tau de Kendall (tau):
- Condiciones: Método no paramétrico alternativo a Spearman, especialmente indicado cuando el tamaño de la muestra es pequeño o existen bastantes empates en los rangos.
Dos variables cualitativas
Evalúan si la distribución de categorías de una variable (categórica, obviamente) depende de otra mediante una tabla de contingencia.
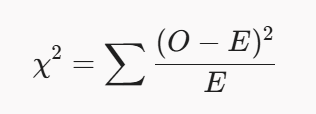
- Test de Chi-cuadrado de Independencia (chi al cuadrado):
- Condición: Evalúa la hipótesis nula (H0) de independencia entre dos variables categóricas. Requiere que las frecuencias esperadas en cada celda de la tabla sean mayores o iguales a 5 en al menos el 80% de las celdas.
- Fórmula: La que aparece arriba (donde O representa la frecuencia observada y E la frecuencia esperada bajo independencia).
- V de Cramer:
- Función: El test chi cuadrado indica si existe dependencia, pero su valor escala con el tamaño de la muestra. La V de Cramer normaliza el resultado entre 0 (sin asociación) y 1 (asociación perfecta) para medir la fuerza de dicha relación.
Variable categórica vs. variable cuantitativa
Estas llamadas «pruebas de hipótesis» o de comparación de grupos, analizan si los valores de una variable continua difieren sustancialmente según los grupos definidos por una variable categórica. Sirven, por ejemplo, para evaluar si el precio medio de un videojuego varía significativamente entre juegos que solo soportan Windows frente a los que soportan Windows, Mac y Linux.
- Prueba t de Student / ANOVA (F-test):
- Paramétrico: Compara las medias de 2 grupos (t-Student) o de más de 2 grupos (ANOVA).
- Supuestos clave: Normalidad en cada grupo y homocedasticidad (homogeneidad de varianzas entre grupos, verificable mediante el Test de Levene).
- Prueba de Mann-Whitney U / Kruskal-Wallis:
- No paramétrico: Alternativas a la t-Student (2 grupos) y ANOVA (>2 grupos) respectivamente, empleadas cuando los datos no cumplen el supuesto de normalidad o las varianzas son heterogéneas.
Presentamos una tabla resumen a continuación:
| Variable X | Variable Y | Supuesto Paramétrico (Normalidad / Homocedasticidad) | Prueba / Métrica Estadística de Relación |
| Numérica | Numérica | Cumple supuestos (Relación lineal) | Pearson (r) |
| Numérica | Numérica | No cumple supuestos (Monotónica / Valores atípicos) | Spearman (rho, parecido a una p) / Kendall (tau) |
| Categórica | Categórica | Frecuencias esperadas mayor o igual que 5 | Chi-cuadrado (chi al cuadrado) + V de Cramer |
| Categórica (2 grupos) | Numérica | Cumple normalidad y homocedasticidad | t de Student |
| Categórica (2 grupos) | Numérica | No cumple supuestos | Mann-Whitney U |
| Categórica (>2 grupos) | Numérica | Cumple normalidad y homocedasticidad | ANOVA (F-test) |
| Categórica (>2 grupos) | Numérica | No cumple supuestos | Kruskal-Wallis |
Esta página está licenciada bajo CC BY-NC-SA 4.0 por Laboratorios Narratech.